고정 헤더 영역

상세 컨텐츠
본문
반응형
AI effort
Claude Code
Opus 5.5
Fable 5.1
GPT-6 Astra
추론 강도
토큰 절약
AI 코딩
X에 올라온 한 정리 글이 "Claude Fable 5.1도, Opus 5.5도, GPT-6 Astra도 effort(추론 강도)를 Max로 올린다고 항상 좋아지지는 않는다"고 주장했습니다. 이걸 이해하면 토큰도 제대로 아낄 수 있다는 이야기까지 붙어 있습니다.
그런데 공식 문서와 근거로 인용된 Claude 글을 대조해 보면 맞는 부분과 조건이 붙는 부분이 갈립니다. Max가 손해인 작업도 있고, 오히려 Max가 결과를 가르는 작업도 있습니다. 이 글은 어떤 작업에서 effort가 효과를 내는지, 어떤 실패는 effort로 못 고치는지, 시간과 비용이 얼마나 차이 나는지, 상황별로 무엇을 고를지 네 가지 축으로 확인합니다. 기준 시각은 2026년 9월 29일입니다.
30초 요약
- "Max가 항상 최고는 아니다"는 사실입니다. Anthropic 자체 글에서도 높은 effort가 과잉 사고로 이어질 수 있다고 적었습니다.
- Thariq의 실험에서 같은 운동 기록 앱을 상세한 스펙으로 만들게 했을 때 걸린 시간은 Low 16분, Medium 22분, High 33분, Max 79분이었습니다. 약 4.9배 차이입니다.
- effort가 올라가면 늘어나는 것은 검증과 엣지케이스 테스트입니다. 이 덕에 보안·하드웨어처럼 숨은 예외가 많은 작업은 성공률이 크게 오릅니다.
- 반대로 방향 자체가 틀린 요청은 Max로도 잘 안 고쳐집니다. 방향은 사람이 잡아야 합니다.

돌고 있는 주장 9개, 확인 결과
| 돌고 있는 주장 | 확인 결과 | 근거(기준일 9/29) |
|---|---|---|
| 모든 작업에서 Max가 최선은 아니다 | 사실 | Anthropic 비용 글: 높은 effort는 과잉 사고로 시간·비용을 늘리고 품질을 깎을 수 있다고 명시 |
| 운동 기록 앱: Low 16분, Medium 22분, High 33분, Max 79분 | 사실 | Claude Code 팀 Thariq의 9/25 글 FIG C, 상세 스펙을 주고 실행한 결과(모델 표기는 글에 따로 없음) |
| 상세 스펙을 주면 모든 effort에서 결과물이 비슷하다 | 일부 사실 | "훨씬 비슷했다"가 원문 표현이고, Max는 세부 사항을 일부 단순화했다고 함 |
| 높은 effort는 검증(테스트·반례)을 늘린다 | 사실 | HTML 필터 과제: Low는 약 2분에 페이지 하나로 확인, 고effort는 약 33분에 XSS 테스트·퍼저까지 수행 |
| Max여도 잘못된 접근·해석은 못 고친다 | 사실(근사치) | Terminal-Bench 3.0 분석: 엣지케이스 관련 실패는 줄고 "잘못된 해석을 고른" 실패는 오히려 늘어남(모델 판정 기준) |
| Fable 5.1·Opus 5.5·GPT-6 Astra 모두 low~max 5단계다 | 사실 | Claude 문서와 OpenAI 모델 페이지 모두 low·medium·high·xhigh·max 지원(Astra는 none 미지원) |
| 뒷받침하는 연구가 두 건 있다 | 일부 사실 | 논문은 실재하지만 학생 창의적 문제 해결 연구이고 effort 설정을 실험한 연구는 아님 |
| 초보자는 높은 effort, 숙련자는 낮은 effort로 충분하다 | 해석 | 공식 근거는 "상세 스펙일수록 결과가 비슷하다"까지이고, 숙련도로 나누는 기준은 공식 자료에 없음 |
| 토큰도 아낄 수 있다 | 사실 | Fable 5.1 HLE: Low 약 53%(문항당 약 0.30달러) vs Max 약 61%(약 2.23달러), 마지막 단계 이득은 약 0.5%p |
1. effort는 지능 스위치가 아니라 '얼마나 일할지'의 신호입니다
Anthropic 문서는 effort를 응답에 쓰는 토큰의 양을 조절하는 값으로 정의합니다. 텍스트 답변만이 아니라 도구 호출과 생각(thinking)까지 전부 포함됩니다. 그래서 낮추면 도구 호출이 줄고 말이 짧아지며, 높이면 계획을 설명하고 더 많이 확인합니다.
Thariq의 비유가 이해하기 쉽습니다. 12시간 동안 하라고 하면 있는 힘껏 하겠지만, 1시간 안에 달라고 하면 요구에 맞는 최선의 버전을 주고 이후에 고치자고 하겠죠. effort도 같습니다. 높을수록 Claude가 판단과 검증을 스스로 더 많이 하고, 낮을수록 사람과 왕복하며 다듬는 일을 전제로 움직입니다.
Using Claude Code: Spending your effort / claude.dev Blog
What effort really is and when to use which level in Claude Code, from my own tests of three builds and a deep dive into Terminal-Bench 3.0 on Opus 5.5 and Fable 5.1.
claude.dev
모델별 기본값도 알아 두면 좋습니다. Claude 문서 기준으로 Opus 5.5의 기본값은 medium이고, 다른 대부분의 모델(Fable 5.1, Sonnet 5.5 API 등)은 high입니다. 설정을 만진 적이 없다면 Opus 5.5는 한 단계 낮은 상태로 이미 돌고 있는 셈입니다. GPT-6 Astra는 OpenAI 모델 페이지에 low·medium·high·xhigh·max가 지원된다고 적혀 있고, none은 쓸 수 없습니다.
Effort
Control how many tokens Claude uses when responding with the effort parameter, trading off between response thoroughness and token efficiency.
platform.claude.com
GPT-6 Astra Model | OpenAI API
GPT-6 Astra is our most capable model, built for the hardest end-to-end work. Use it for complex reasoning, coding, computer use, research, and document creation. reasoning.effort supports low, medium, high, xhigh, and max. Get started with GPT-6 Astra usi
developers.openai.com
2. 같은 앱인데 16분과 79분: 스펙이 상세할 때의 시간 차이
Thariq는 Opus 5.5를 중심으로 "개인 피트니스·운동 기록 앱" 등을 만들게 하는 실험을 세 가지 조건으로 했습니다. 상세 스펙 조건은 여러 모델에 같은 스펙을 넘겼다고 적었습니다.
- 한 줄 요청: effort에 따라 결과가 크게 달라졌습니다. Low는 기록과 간단한 그래프 정도였고, Max에는 히트 차트까지 들어갔습니다.
- 디자인 탐색: 설정 메뉴 개편안을 Low는 1분, Max는 28분에 만들었습니다. 방향을 빨리 보려면 Low가 낫고, 완성도가 필요하면 Max가 낫다는 결론입니다.
- 상세 스펙: Claude에게 인터뷰를 시켜 스펙을 만든 뒤 넘기자 결과물이 훨씬 비슷해졌고, 시간은 Low 16분에서 Max 79분까지 벌어졌습니다.
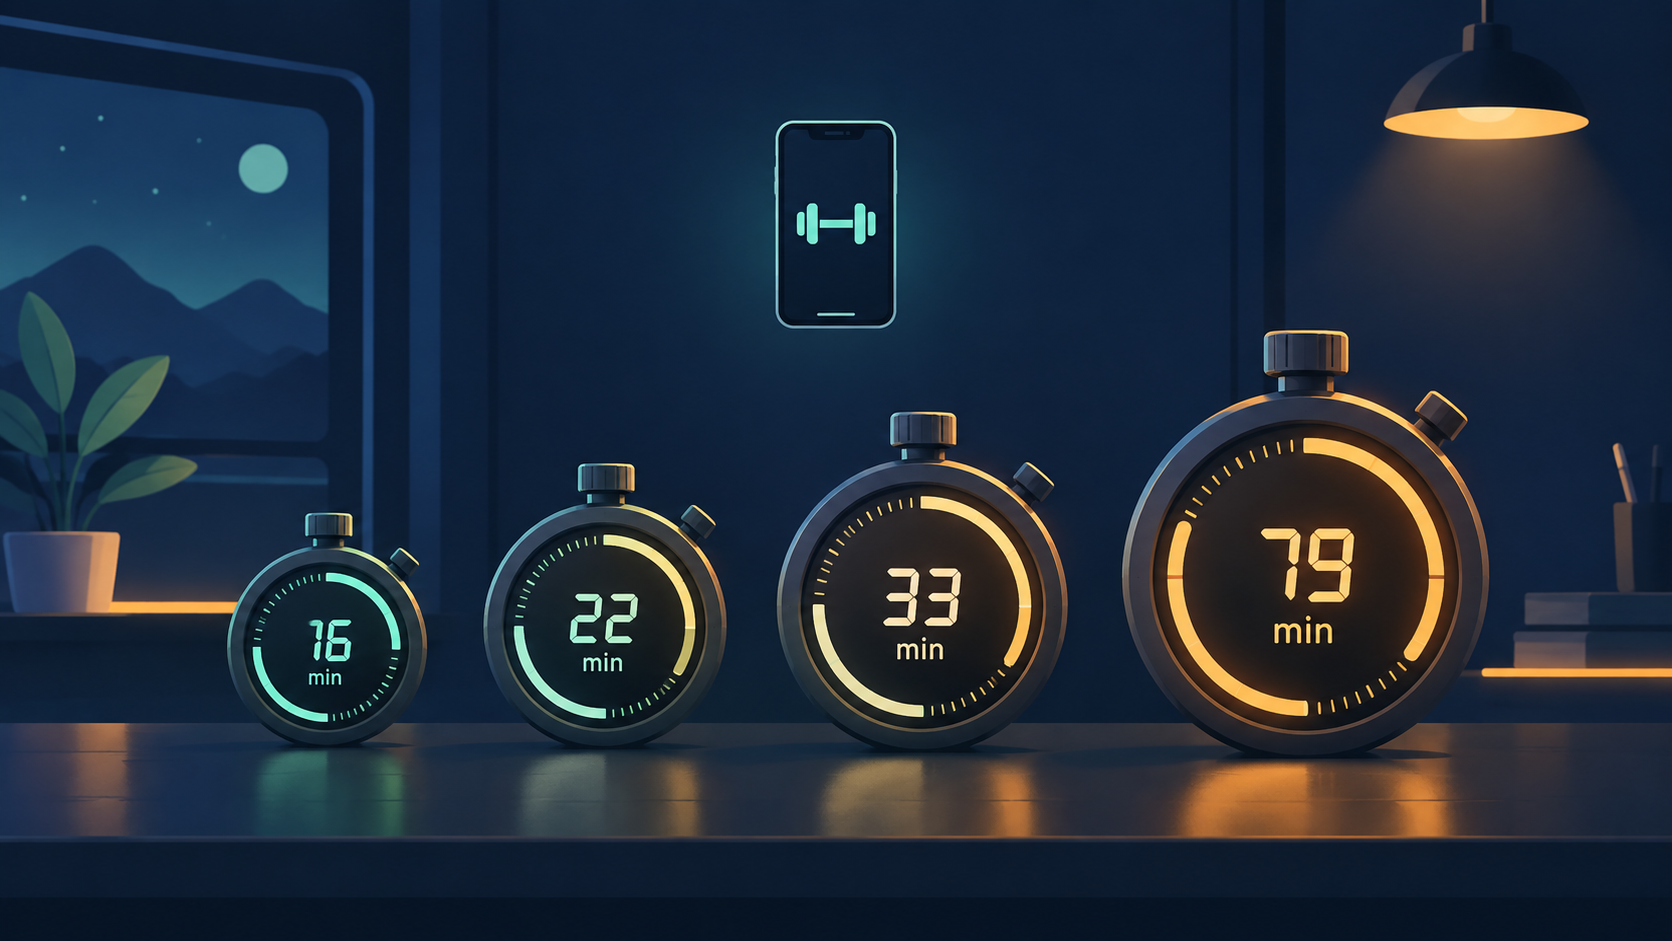
여기서 읽어야 할 것은 스펙이 상세하면 결과물 차이는 줄어드는데 시간 차이는 남는다는 점입니다. 상세하게 지시하는 사람에게 Max는 결과가 비슷한 일에 4.9배의 시간을 쓰는 선택일 수 있습니다. 반대로 한 줄로 시키고 알아서 판단하게 할수록 effort의 차이가 결과물에 그대로 나타납니다.
3. 높은 effort가 늘리는 것은 검증입니다
가장 분명한 사례는 Terminal-Bench 3.0의 HTML 필터 과제(html-js-filter)입니다. 페이지에 자바스크립트를 몰래 넣는 모든 방법을 막는 필터를 만드는 문제인데, Fable 5.1은 Low에서 5번 중 1번, xhigh에서 5번 중 5번 성공했습니다.
- Low(약 2분): 한 번에 필터를 쓰고 직접 쓴 페이지 하나로 확인한 뒤 끝냈습니다.
- 고effort(약 33분): 초안을 스스로 공격적으로 검토하고, 파서 소스를 읽어 버그를 확인하고, 정상 입력이 그대로 나오는지 시험하고, 표준 XSS 테스트를 돌리고, 마지막에 무작위 문서 퍼저까지 만들었습니다.
Opus 5.5 사례도 같은 패턴입니다. 저장 엔진 버그를 고치는 과제는 Low(시도당 약 1분)에서 0/5, xhigh(약 11분)에서 4/5였습니다. Low는 재현 없이 코드부터 고쳤고, xhigh는 먼저 충돌을 재현하고 무작위 테스트를 쓰고 그 테스트가 미완성 수정에서 실패하는지까지 확인했습니다.
분야별 합격률로 보면 효과가 어디에 몰리는지 보입니다. Fable 5.1 기준 낮은 effort에서 높은 effort로 올렸을 때 보안 64%에서 87%, 하드웨어 34%에서 75%로 크게 뛰었고, 운영(12%에서 22%)이나 미디어(18%에서 30%)는 상승폭이 작았습니다. 숨은 예외가 많은 작업일수록 검증이 결과를 바꾼다는 이야기입니다.
4. Max로도 못 고치는 실패: 방향이 틀린 요청
Thariq는 Terminal-Bench 3.0의 실패 유형을 분류해 봤습니다. Fable 5.1이 각각 370번 시도한 결과를 Low와 Max로 비교하면, 성공은 140번에서 214번으로 늘었습니다.
- 줄어든 실패: 테스트가 놓친 버그 40건에서 14건, 요구사항을 잘못 읽은 경우 45건에서 26건, 불완전한 수정 31건에서 10건.
- 그대로이거나 늘어난 실패: 잘못된 해석을 고른 경우가 25건에서 47건으로 오히려 늘었습니다. 전체 실패가 230건에서 156건으로 줄어든 가운데 이 유형의 비중은 약 11%에서 30%로 커졌습니다.

실패 유형은 모델 판정으로 분류한 근사치라는 단서가 원문에 붙어 있습니다. 그래도 방향은 분명합니다. effort는 맞는 방향으로 가는 차의 검증을 강화하지만, 방향이 틀린 차를 더 빠르게 몰게 하는 경우도 있습니다. 요구사항이 애매한 채로 Max를 켜는 것보다 요구사항을 먼저 구체화하는 편이 이득입니다.
반대편 함정도 있습니다. Anthropic은 effort를 너무 낮게 잡으면 근거가 충분히 모이기 전에 멈추고, 답은 완성돼 보이지만 부분 정보 위에 서 있는 결과가 나온다고 경고합니다. 높이는 실수와 낮추는 실수 둘 다 실제로 존재합니다.
Reducing cost and improving performance with Claude Platform | Claude by Anthropic
Tuning prompt caching, instructions, and effort can reduce Claude's cost without sacrificing application performance.
claude.com
5. 상황별 effort 선택표
Thariq의 실사용 기준과 Claude 문서의 권장을 겹쳐서 정리했습니다. 아래 표는 출발점이고, 최종 판단은 자신의 작업으로 한 번씩 비교해서 정하는 것이 공식 문서의 권고이기도 합니다.
| 하려는 일 | 시작 effort | 이유 |
|---|---|---|
| 브레인스토밍, 스케치, 쉬운 수정 | Low | 사람과 빠르게 주고받는 게 핵심이고, 한 번에 완벽한 답이 목표가 아님 |
| 스펙이 정해진 신규 기능 구현 | Medium | Thariq의 일상 기준이며 Sonnet 5.5 문서도 잘 정의된 작업은 medium부터 권장 |
| 기존 코드의 버그 수정, 검증이 중요한 작업 | High | 재현과 테스트를 충분히 하는 구간, 엣지케이스가 많을수록 유리 |
| 보안 점검, 성능 최적화, 예외가 많은 작업 | High~xhigh | 분야별 합격률 상승폭이 가장 큰 영역 |
| 사람 개입 없이 끝까지 맡기는 장시간 작업 | xhigh~Max | xhigh는 30분 이상 장시간 작업용, Max는 완전 자율 작업에 사용한다는 Thariq의 기준 |
| 서브에이전트, 대량의 단순 처리 | Low | Claude 문서가 low의 대표 용도로 서브에이전트를 지목 |
표에서 Max가 맨 아래 한 줄에만 나오는 이유는 간단합니다. 사람이 중간에 방향을 고쳐 줄 수 없는 상황에서만 Max의 스스로 판단하는 힘이 값어치를 하기 때문입니다.
6. 토큰을 실제로 아끼는 순서
Thariq가 신규 기능 개발에서 쓴다는 루프가 가장 실용적입니다.
- 1단계: 대략적인 스펙을 주고 빠진 부분을 Claude가 나에게 인터뷰하게 시킵니다.
- 2단계: Low로 구현시킵니다.
- 3단계: 결과를 검토하며 큰 그림이 맞는지 확인하고 필요하면 Low로 반복합니다.
- 4단계: 마지막에 High로 검증과 테스트만 돌립니다.
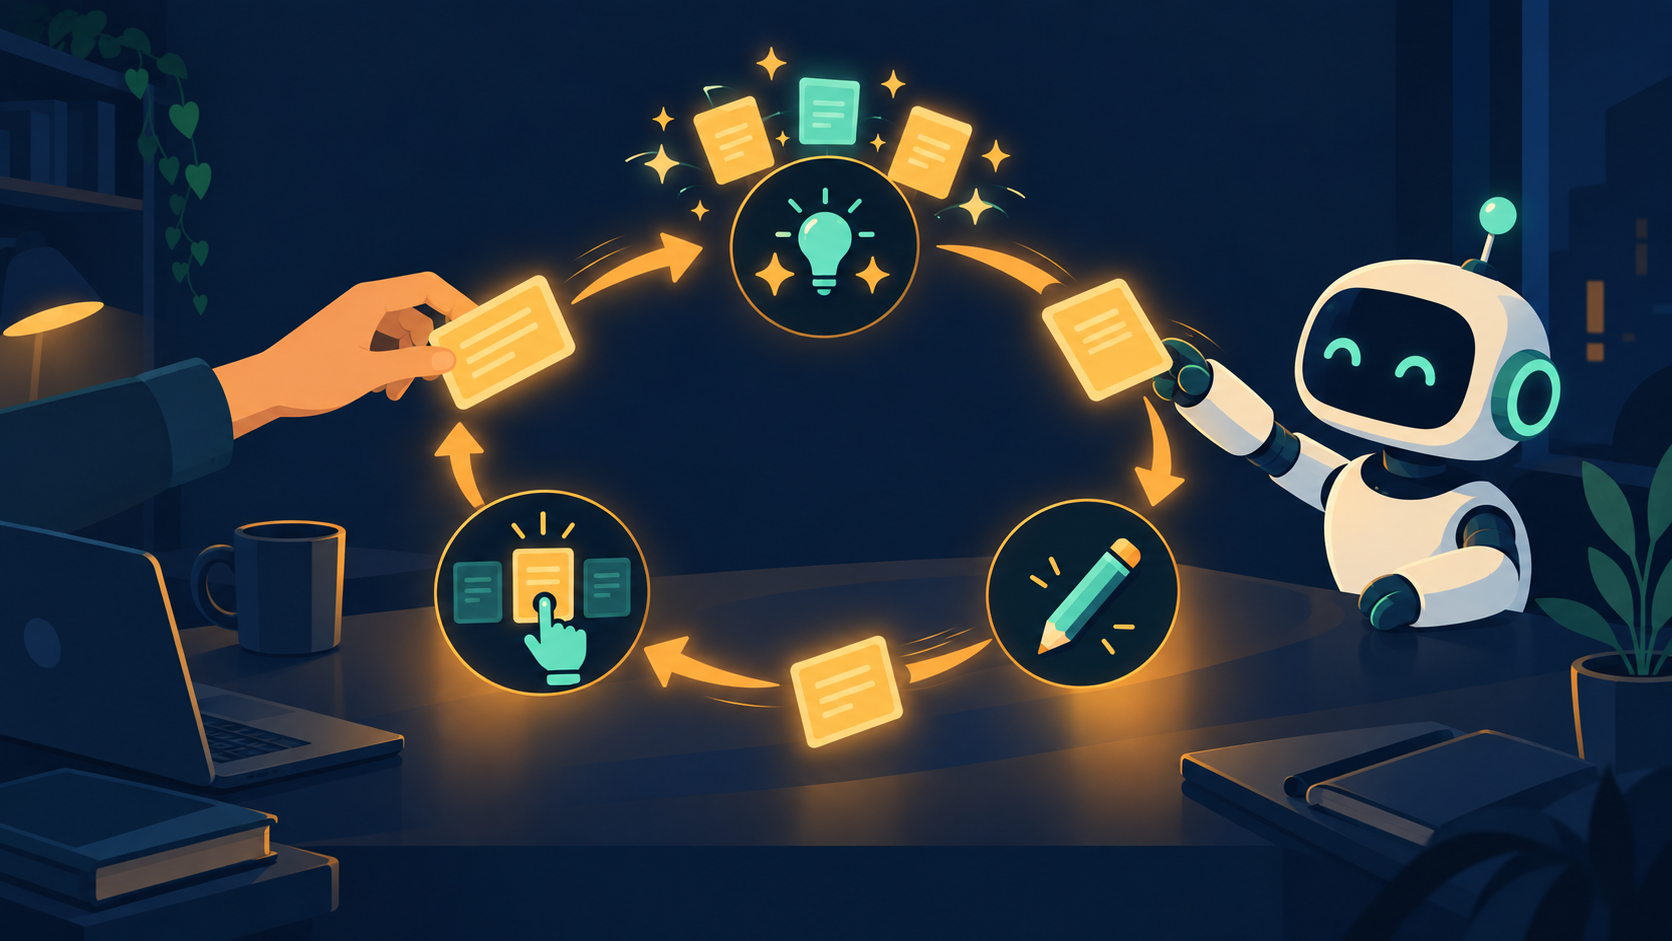
이 루프가 토큰을 아끼는 이유는 둘입니다. 사람이 방향을 이미 정해 두었으니 비싼 판단을 AI에게 맡길 필요가 줄어들고, 비싼 effort는 검증이라는 가장 값어치 있는 구간에만 쓰이기 때문입니다. 창의적 문제 해결을 다룬 연구들도 결과가 좋은 사람들은 한 번에 시키지 않고 맥락을 더하고 구체적인 피드백을 주며 여러 번 주고받았다고 보고합니다. 다만 이 논문들은 effort 설정이 아니라 학생과 ChatGPT의 협업을 본 연구라, 간접 근거로만 보는 것이 맞습니다.
참고한 논문: Prompting for creative problem-solving: A process-mining study (Learning and Instruction, 2025), Student-AI collaborative creative problem-solving: The role of human agency (Computers & Education, 2025)
추가로 확인해 둘 실전 팁 네 가지입니다.
- 강한 모델을 낮은 effort로: CursorBench 3.2에서 Fable 5.1 Low가 Fable 5 High와 비슷한 성능을 3분의 1 비용으로 냈다고 Anthropic이 밝혔습니다. 모델을 올리고 effort를 내리는 조합도 시험해 볼 만합니다.
- "두 번 확인해", "최대한 꼼꼼히" 같은 문구는 빼기: Anthropic은 이런 의식 문구가 최신 모델에서는 불필요한 도구 호출과 토큰 낭비로 이어진다고 설명합니다.
- 대화 중 effort를 바꾸면 캐시가 깨질 수 있음: Claude는 Opus 5.5·Fable 5.1 등 일부 모델에서 메시지 단위 변경(베타)으로 캐시를 유지하고, OpenAI는 GPT-6에서 configuration_update 항목으로 같은 일을 합니다. 세션 초반에 정하고 유지하는 것이 기본입니다.
- Claude Code에서 바꾸는 법: 세션 중에는 /effort, 한 번만 바꾸려면 claude --effort high처럼 실행 옵션을 씁니다. /effort auto로 모델 기본값으로 되돌립니다.
Reasoning models | OpenAI API
Learn how to use OpenAI reasoning models in the Responses API, choose a reasoning effort, manage reasoning tokens, and keep reasoning state across turns.
developers.openai.com
참고로 Anthropic은 Opus 5.5가 기본 medium에서 지식 업무에 한해 GPT-6 Astra의 Max보다 좋은 성적을 약 5분의 1 비용으로 냈다고 발표했습니다. 자체 발표라는 점을 감안해야 하지만, 모델과 effort를 함께 고르라는 신호로는 충분합니다.
Introducing Claude Opus 5.5
Claude Opus 5.5 leads in agentic coding and knowledge work, and costs 40% less to run than Opus 5 on typical workloads.
www.anthropic.com
7. 직접 확인하지 못한 부분
- 16분·22분·33분·79분을 포함한 실험 수치는 Anthropic 팀이 자체 실행한 결과를 그대로 옮긴 것이고, 이 글에서 다시 재현하지는 않았습니다. 원문도 개별 사례 일부는 중간 effort 설정이라고 밝히고, 시간표(FIG C)가 어느 모델의 값인지는 글에 표기돼 있지 않습니다.
- 논문 두 건은 출판사 사이트가 접근을 막아 본문이 아니라 초록과 요약 수준에서만 확인했습니다. "77명"이라는 숫자는 대학생 77명이 ChatGPT를 쓴 사전등록 실험에서 확인되지만, 인용된 논문의 표본 수와 같은지는 본문으로 대조하지 못했습니다.
- GPT-6 Astra의 effort별 시간·비용 실험은 이 글에 없습니다. Astra는 지원 단계와 mid-conversation 변경 방식만 공식 문서로 확인했습니다.
- "초보자는 높게, 숙련자는 낮게"라는 구분은 공식 자료에 근거가 없어 해석으로 분류했습니다.
이 글은 X에 올라온 effort 정리 글을 계기로 삼아, 공식 글과 문서를 직접 대조해 다시 쓴 것입니다. 같은 날 정리한 클로드 소넷 5.5 출시 정리에는 Sonnet 5.5의 effort 권장이, Opus 5.5 모션 디자인 스튜디오 번역 글에는 effort를 xhigh나 max로 두는 실제 사례가 있고, OpenAI o 에이전트 팩트체크도 상시 실행 에이전트의 흐름을 이해하는 데 참고가 됩니다.
자주 묻는 질문 (FAQ)
Q. effort를 높이면 답이 항상 좋아지나요?
아닙니다. 숨은 예외가 많은 작업에서는 크게 좋아지지만, 방향이 틀린 요청이나 단순 작업에서는 시간과 비용만 늘 수 있습니다. Fable 5.1의 HLE 결과에서는 Low에서 Max로 가는 8%p 상승 중 마지막 단계는 약 0.5%p였습니다.
Q. 지금 Opus 5.5를 쓰는데 뭘로 설정해야 하나요?
기본값이 medium이니 그대로 두고, 검증이 중요한 작업만 high로 올려 비교하는 방식이 무난합니다. 새 모델에 예전 설정을 그대로 가져오지 말고 자신의 작업으로 한 번씩 비교하라는 것이 Claude 문서의 권고입니다.
Q. Max는 언제 쓰나요?
사람이 중간에 개입하지 않고 끝까지 맡기는 어려운 작업입니다. 예를 들어 앱 전체를 만들고 스스로 검증하게 하거나, 중요한 소프트웨어의 보안 취약점을 찾는 경우입니다.
Q. GPT-6 Astra도 같은 원리인가요?
OpenAI 문서도 reasoning.effort를 품질을 되찾는 주된 수단이 아니라 튜닝 노브로 다루라고 안내합니다. 다만 이 글의 시간·성공률 수치는 Claude 모델 기준이라 Astra에 그대로 적용하지는 못합니다.
반응형
'AI 활용' 카테고리의 다른 글
| Opus 5.5 API 설정 — 이전 코드 4가지 점검 한눈에 (0) | 2026.09.30 |
|---|---|
| OpenAI o 에이전트 공개 D-1 — 확인된 것·유출·기능 팩트체크 (0) | 2026.09.29 |
| Opus 5.5로 모션 디자인 스튜디오 만드는 법 — 12단계 풀코스 번역(복붙 자료) (0) | 2026.09.29 |
| 클로드 소넷 5.5 출시 — 가격 동결·속도 30% 개선·API 변경점 (0) | 2026.09.29 |
| 메타 뮤즈 한국 사용법 — 아이폰 설치·리딤코드·활용법 (0) | 2026.09.27 |


