고정 헤더 영역

상세 컨텐츠
본문
반응형
9월 28일(현지 시각) Anthropic이 클로드 소넷 5.5(Claude Sonnet 5.5)를 공개하자, X에는 "30% 빠르고 30% 싸졌다"는 요약이 빠르게 퍼졌습니다. 공식 계정 발표 글은 조회 5만 회를 넘겼죠.
그런데 공식 발표문과 개발자 문서를 대조해 보면 조건이 붙습니다. 토큰 가격은 그대로이고, 기존 코드를 옮기면 바로 에러가 나는 변경점도 있습니다. 이 글은 무엇이 달라졌는지, 30% 절감의 실제 의미, 바로 쓸 때 확인할 것, 맞지 않는 자리 네 가지로 확인합니다.
📌 30초 요약
- 소넷 5.5는 Claude 5.5 제품군의 두 번째 모델로, 9월 28일 모든 플랫폼에 풀렸습니다.
- 토큰 가격은 입력 $2·출력 $10(100만 토큰당)으로 소넷 5와 같습니다.
- 30% 절감은 단가 인하가 아니라 토큰을 덜 써서 생기는 작업당 최대치입니다.
- 출력 속도는 30% 이상 빨라져 역대 가장 빠른 소넷입니다.
- API는 모델 ID만 바꾸면 400 에러가 나는 설정이 있어 코드 점검이 먼저입니다.
1. 클로드 소넷 5.5, 무엇이 달라졌나
소넷 5.5는 9월 22일 나온 오퍼스 5.5에 이은 두 번째 5.5 모델입니다. Anthropic은 오퍼스 5.5를 신중한 판단이 필요한 복잡한 일에, 소넷 5.5를 범위가 분명한 일상 업무·버그 수정·문서와 슬라이드 작성에 맞춘 모델로 설명합니다.
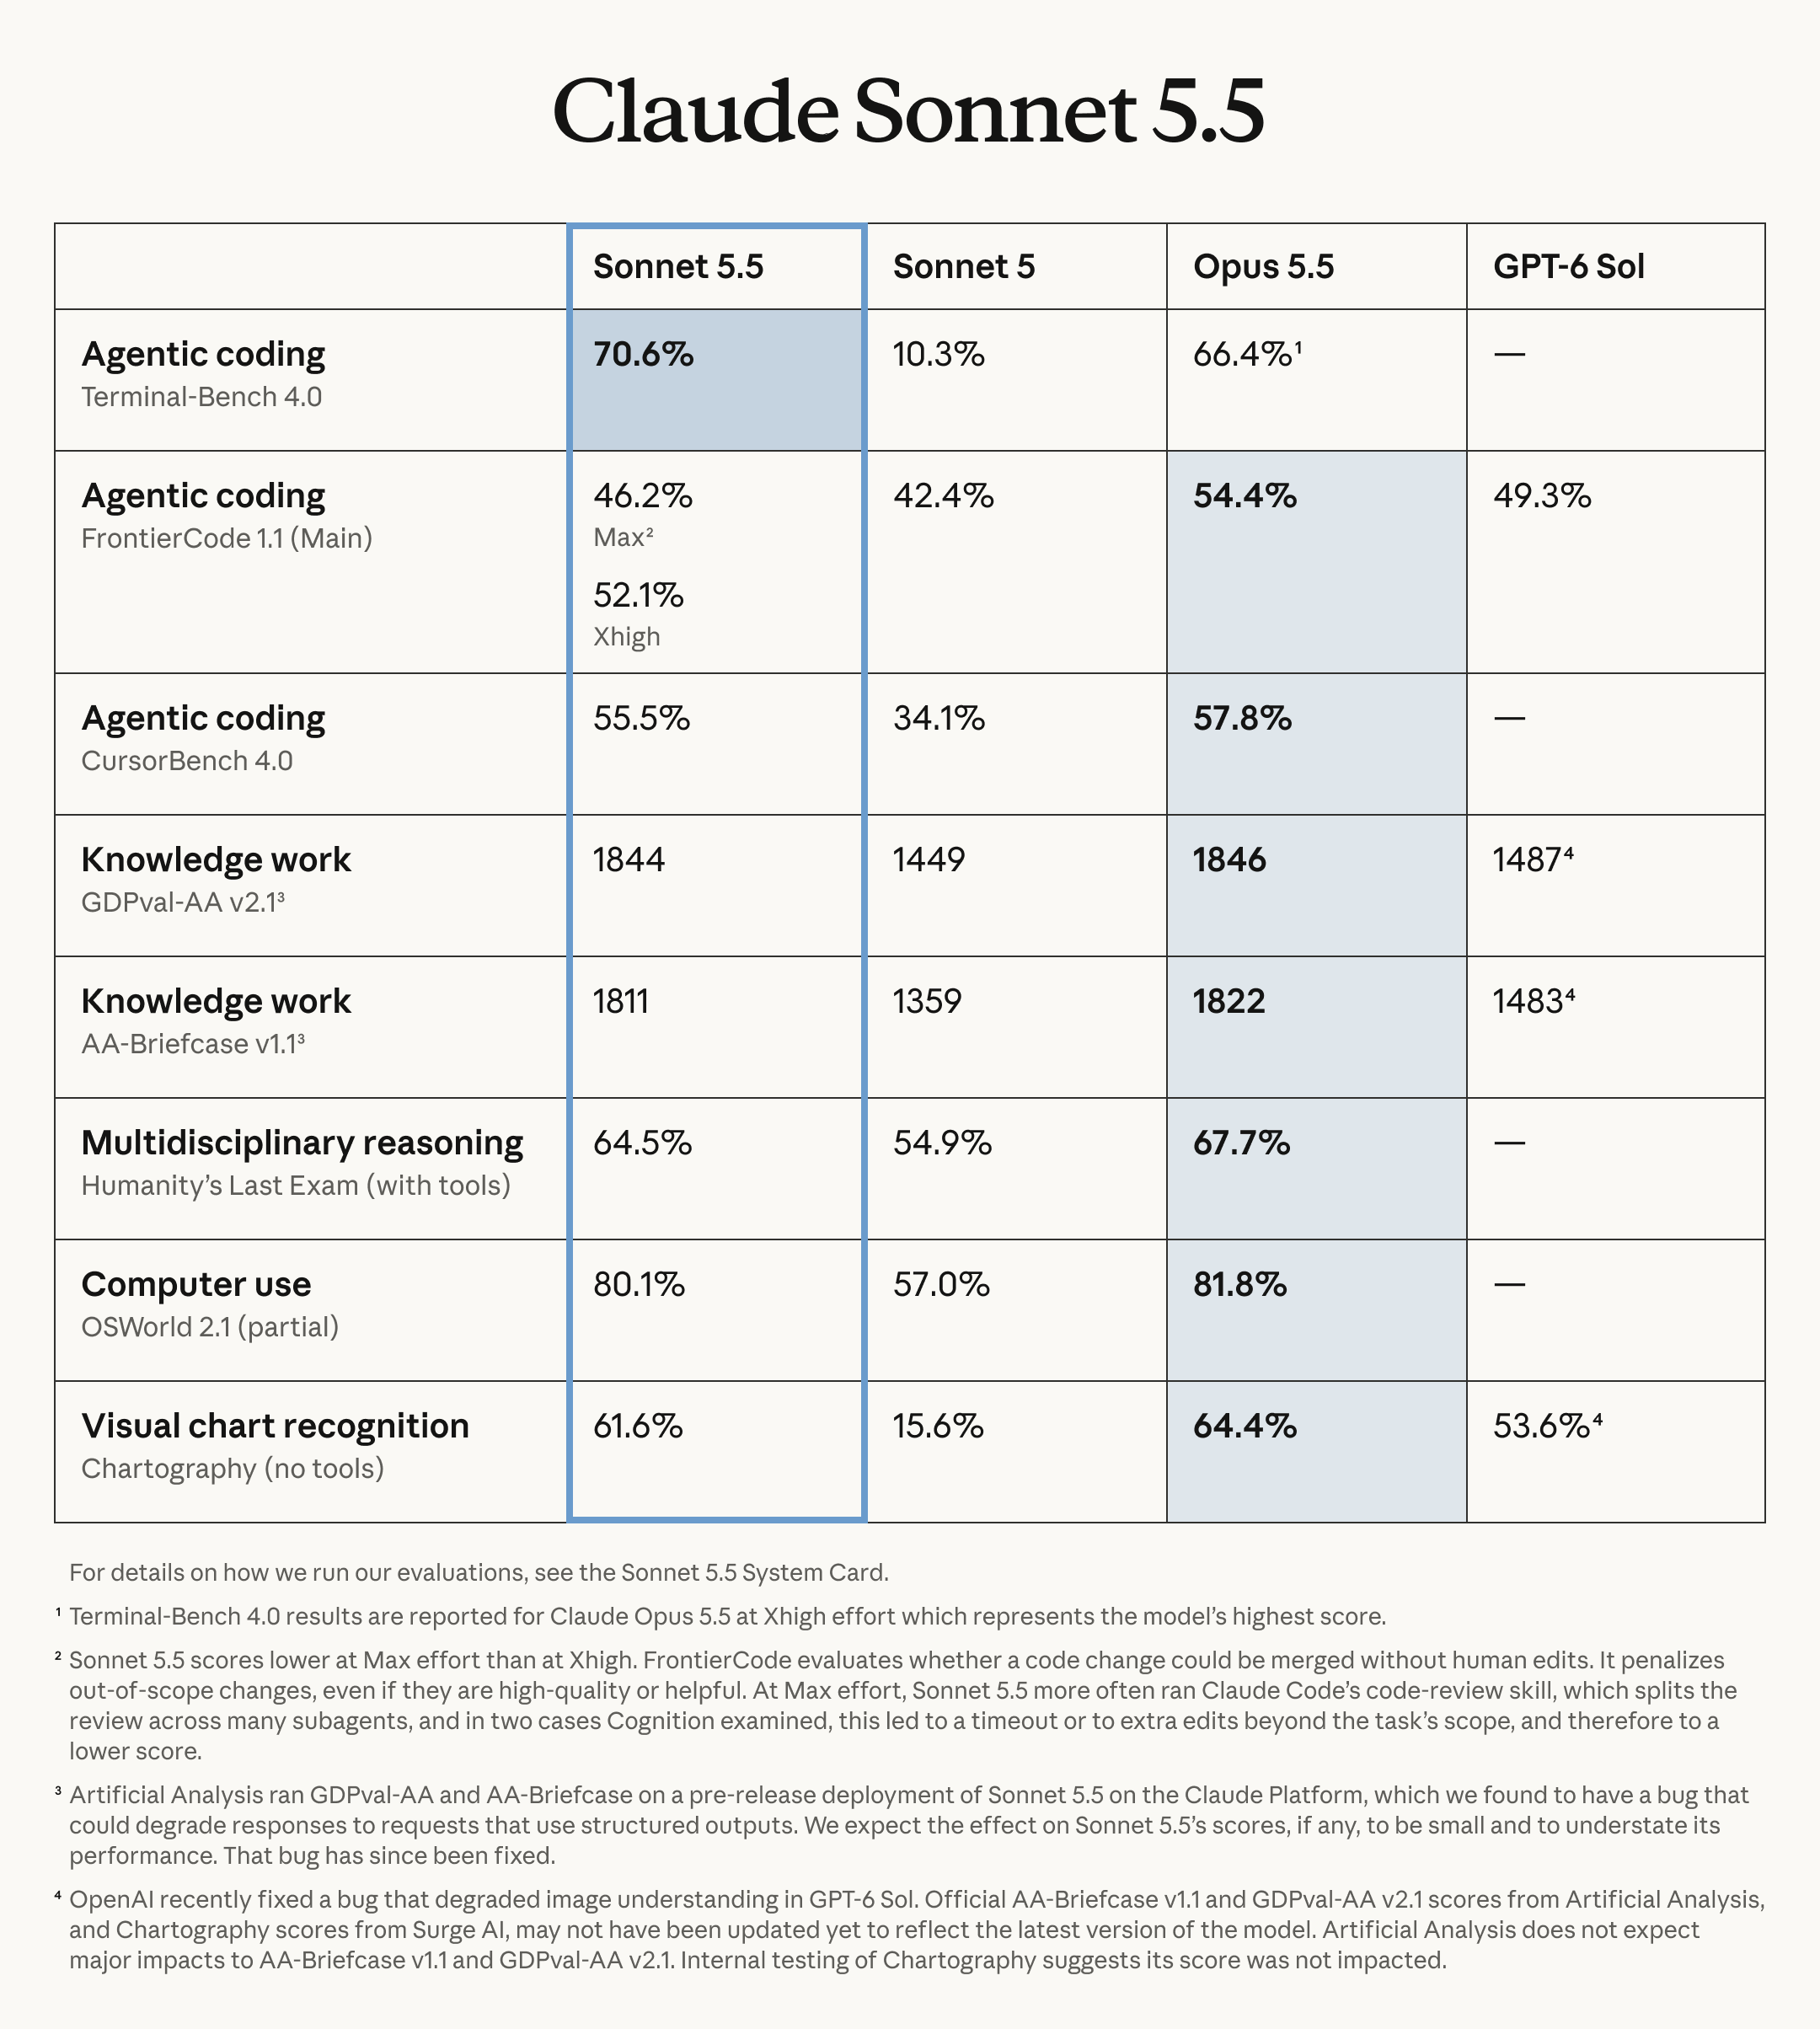
가장 눈에 띄는 숫자는 에이전트 코딩입니다. 터미널벤치 4.0에서 소넷 5는 10.3%, 소넷 5.5는 70.6%를 기록했죠. 여러 직업의 실제 업무를 평가하는 GDPval-AA에서는 1,844점으로 오퍼스 5.5(1,846점)와 2점 차이입니다.
스크린샷만 보고 포켓몬 레드를 깬 첫 소넷이라는 설명도 붙었죠. 사양은 컨텍스트 100만 토큰, 최대 출력 12만 8천 토큰, 학습 데이터 기준 2026년 6월이고, 더 가벼운 하이쿠 5.5는 몇 주 안에 합류할 예정입니다.
2. 30% 싸졌다는 말, 실제로는 이런 뜻입니다
가장 많이 퍼진 말은 "싸졌다"였지만 가격표는 바뀌지 않았습니다. 공식 발표 기준 입력 $2, 출력 $10, 캐시 읽기 $0.20으로 소넷 5와 같죠. 절감은 같은 작업에 쓰는 토큰이 줄어서 생기고, 공식 표현도 작업당 최대 30%입니다.
| 돌고 있는 주장 | 확인 결과 | 근거 |
|---|---|---|
| 소넷 5보다 30% 빠르다 | 사실 | 출력 생성이 30% 이상 빨라짐 |
| 30% 싸졌다 | 일부 사실 | 단가는 동일, 작업당 비용이 최대 30% 감소 |
| 오퍼스 5.5급 성능 | 과장 | 일부 점수만 근접, 복잡한 작업은 오퍼스 우세라고 명시 |
| GPT-6 Sol을 압도 | 일부 사실 | 지식 업무는 앞서지만 FrontierCode는 설정별 46.2~52.1% 대 49.3% |
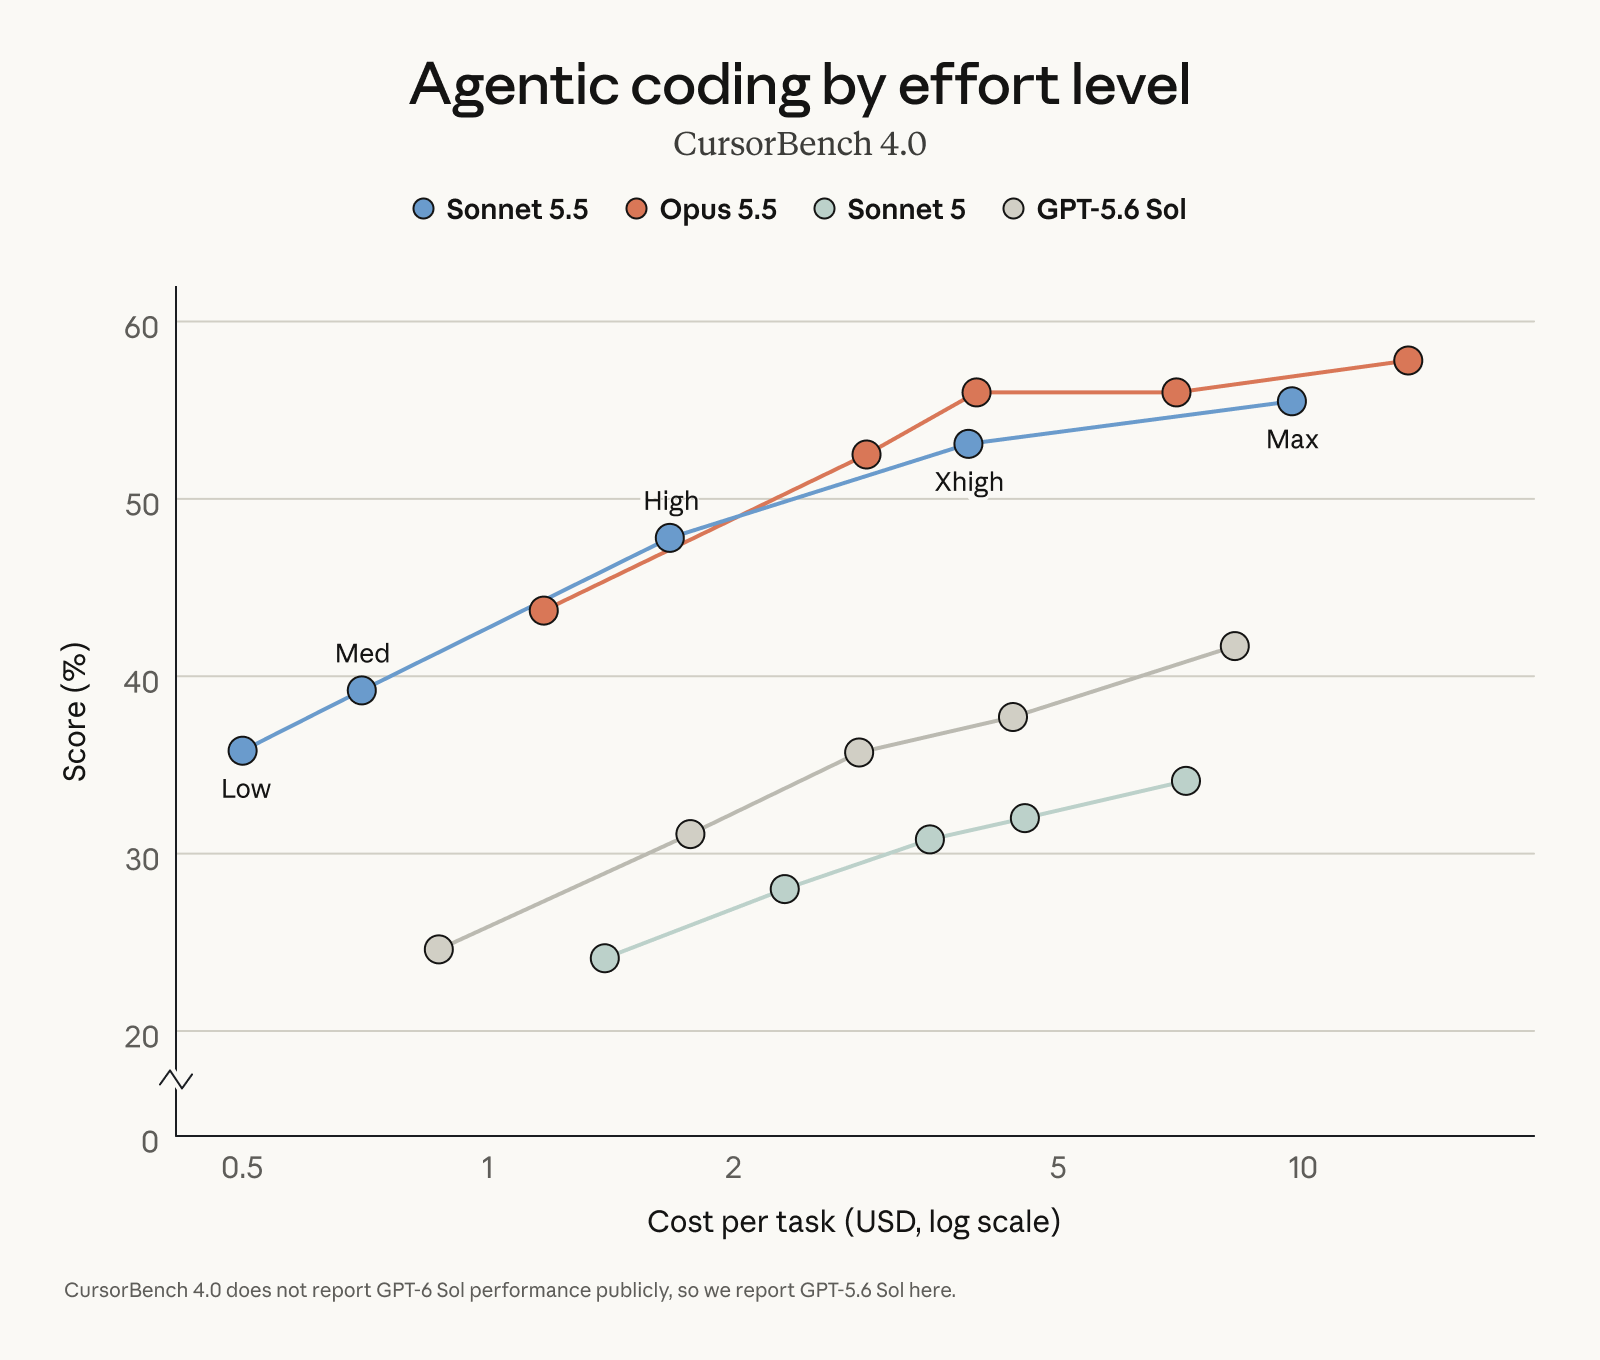
차이가 가장 크게 벌어지는 건 노력 수준(effort) 설정입니다. 공식 차트를 보면 Low·Medium 설정의 소넷 5.5가 소넷 5의 최고 점수를 약 10분의 1 비용으로 넘어서는 벤치마크가 여럿 있습니다.
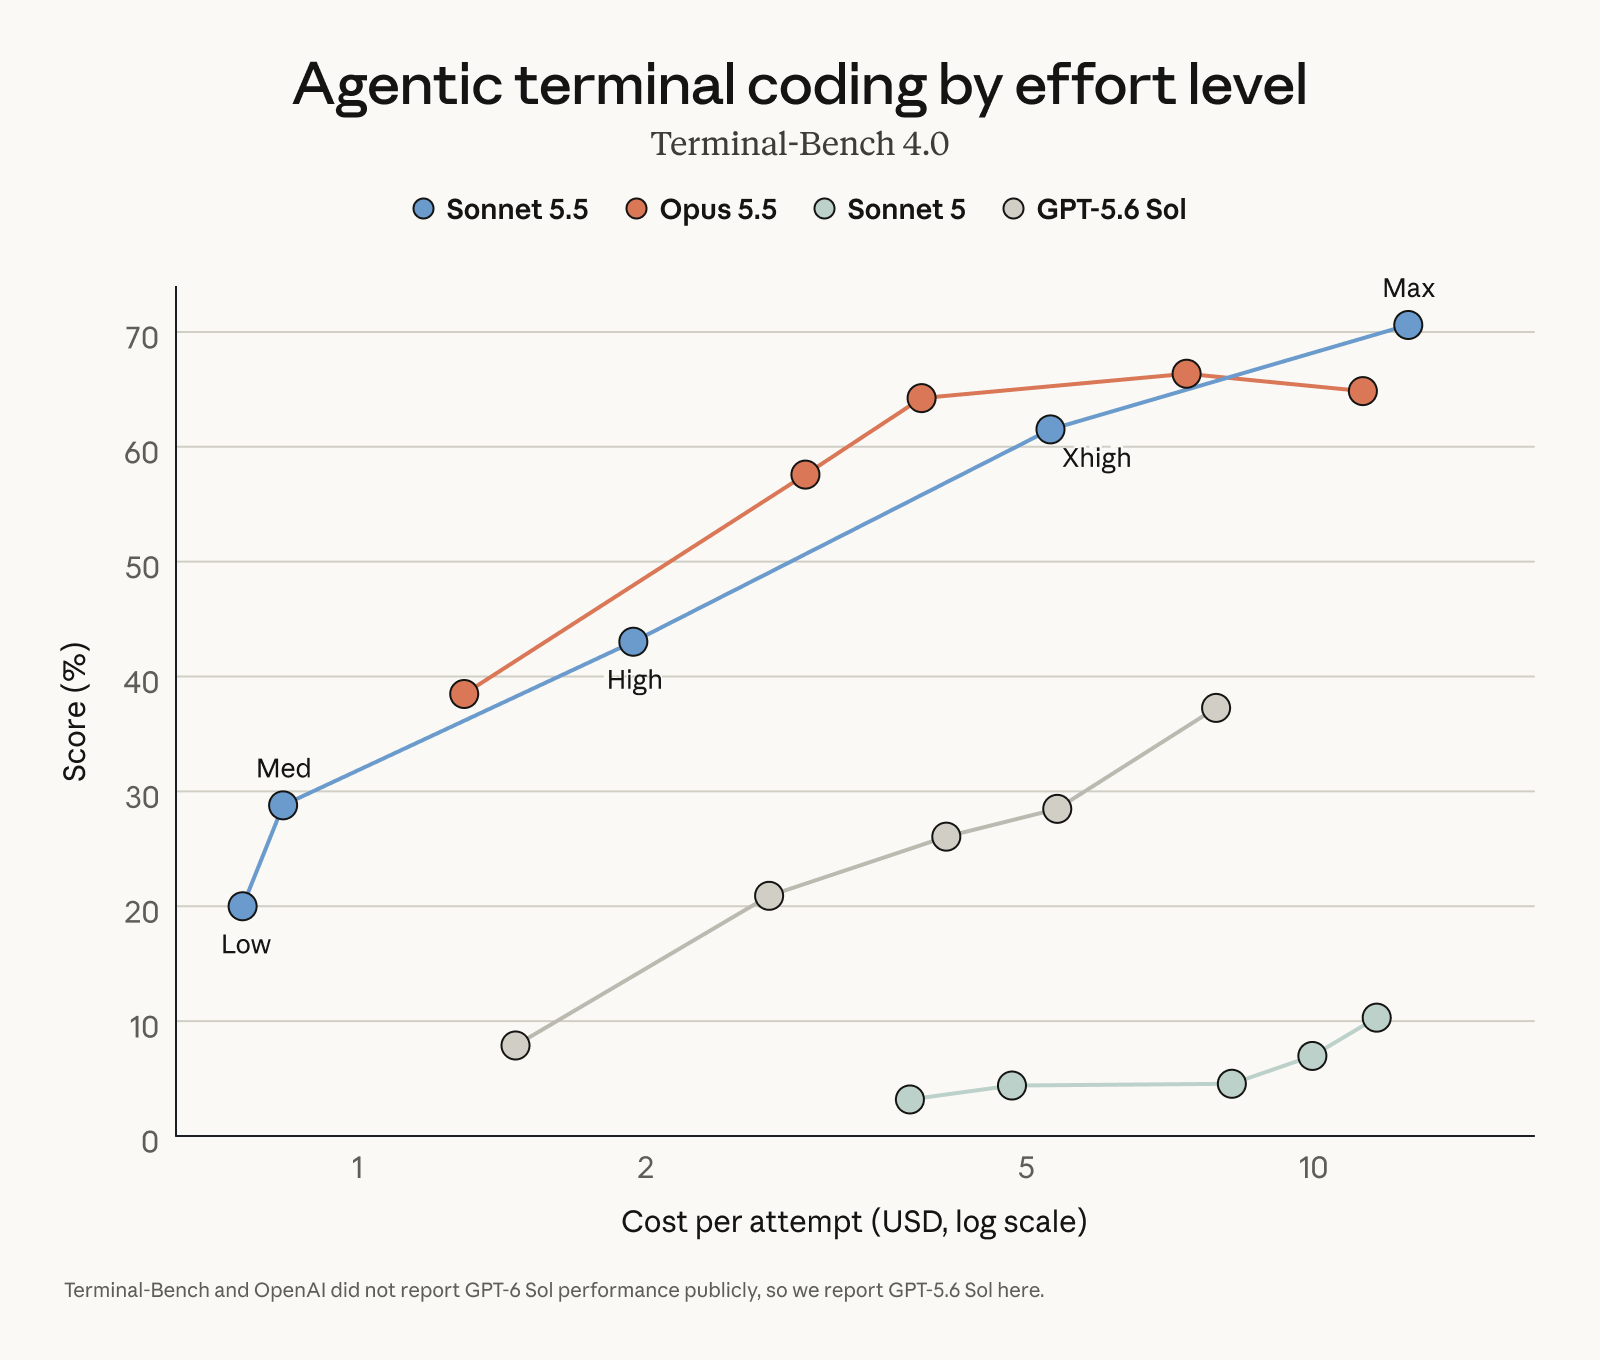
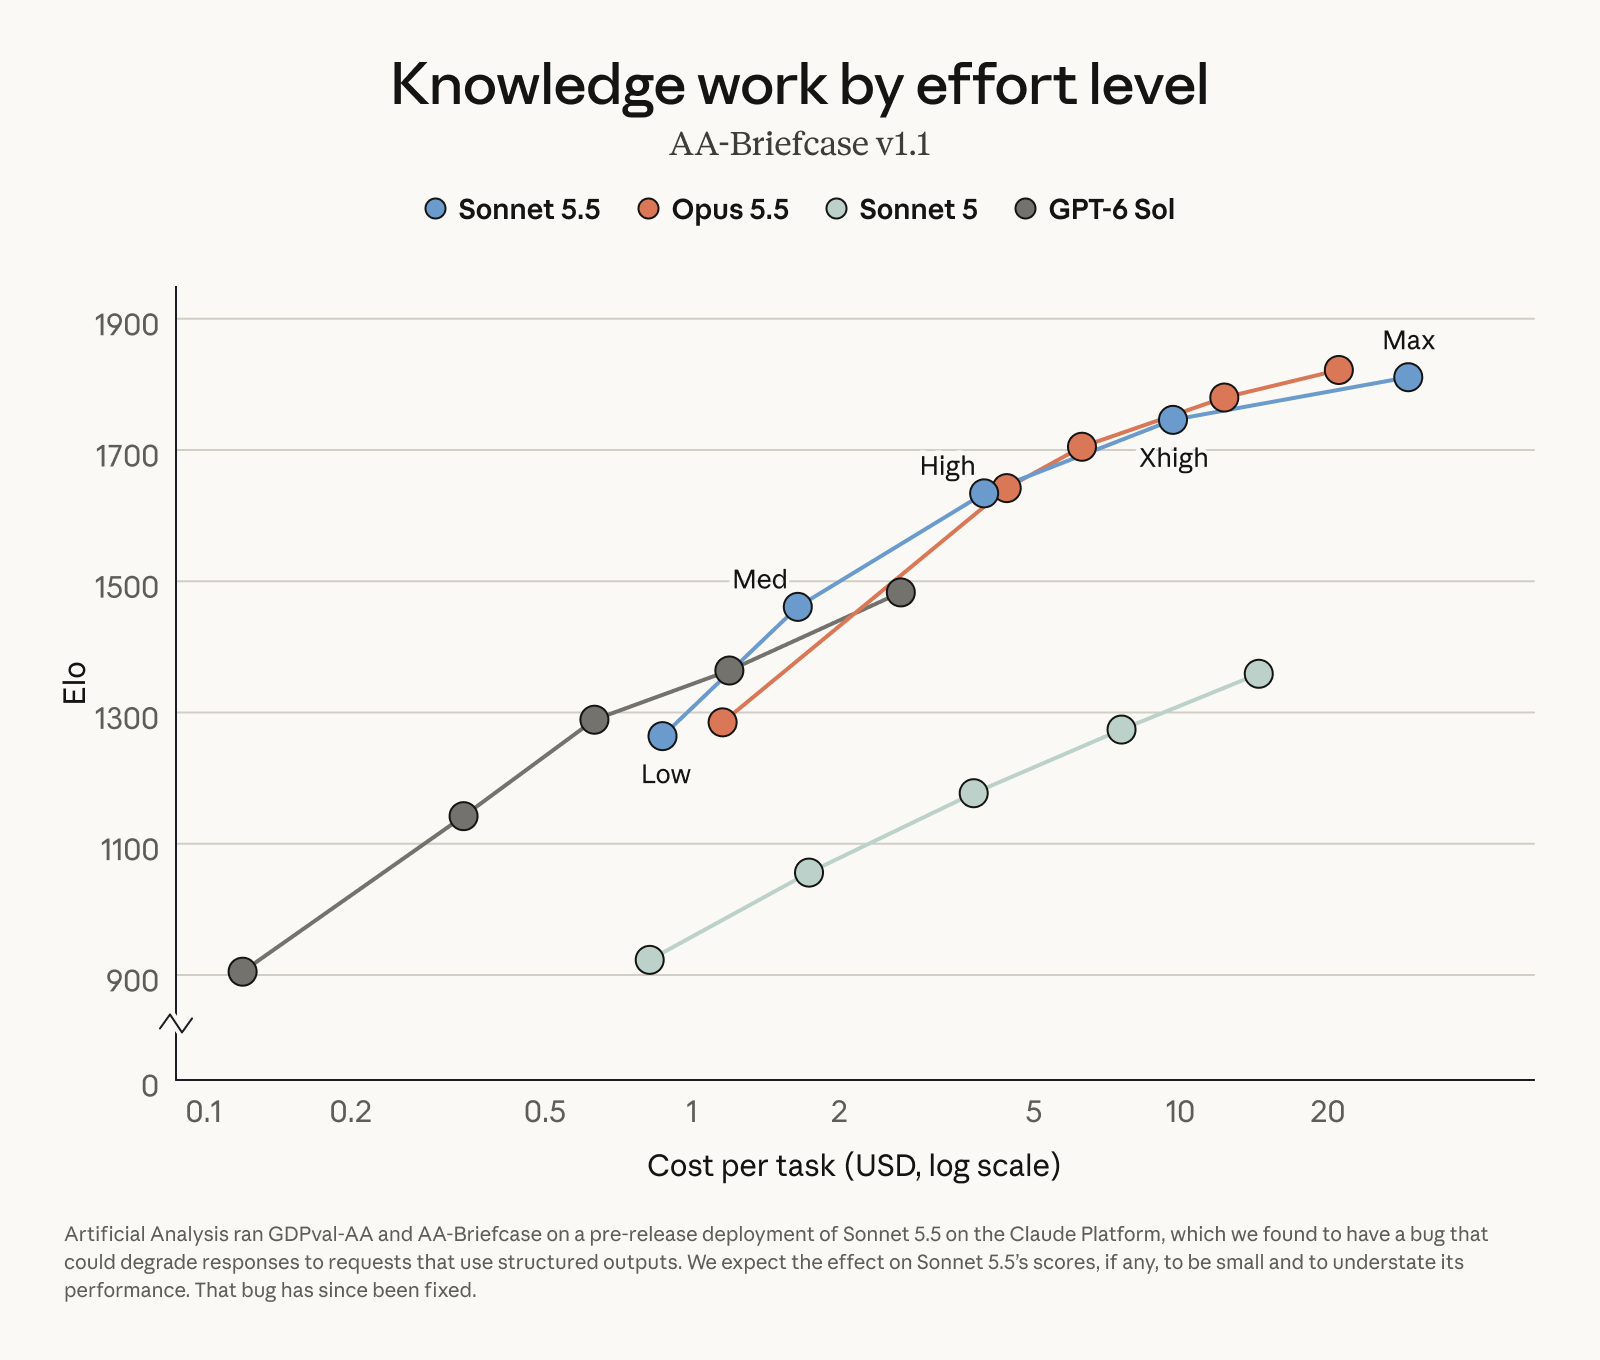
★ 기본값도 다릅니다. Claude 앱과 Claude Code는 Medium, Claude 플랫폼(API)은 High가 기본값이라, 같은 질문도 어디서 쓰느냐에 따라 비용과 답 길이가 달라질 수 있습니다.
3. 바로 쓰려면 먼저 확인할 것
소넷 5.5는 Claude 앱·Claude Code·Claude 플랫폼과 AWS·구글 클라우드·마이크로소프트 등 모든 플랫폼에서 바로 쓸 수 있습니다. API 모델 ID는 claude-sonnet-5-5입니다.
⚠️ 문제는 기존 소넷 5 코드입니다. 마이그레이션 가이드에 따르면 모델 ID만 바꾸면 400 에러가 나는 설정이 있어, 배포 전에 아래 항목부터 찾아보셔야 합니다.
| 지금 코드에 있다면 | 소넷 5.5에서 | 이렇게 바꿉니다 |
|---|---|---|
| thinking: disabled | 400 에러 | between_tools로 교체(High 이하) |
| tool_choice any·tool | 400 에러 | auto + strict 도구 |
| computer_20251124 | API·구글 클라우드에서 에러 | computer_toolset_20260801 |
| 대화 기록 수정 후 재전송 | 8월 31일 이후 계정은 에러 | 대화는 이어 붙이기만 |
| 도구 사이 안내 문구 | 표시가 사라짐 | display 설정 추가 |
직접 확인하지 못한 부분도 밝혀 둡니다. 이 글은 공식 발표문·개발자 문서·공식 X 게시물을 대조한 정리이고, 앱에서 직접 써 본 결과는 넣지 않았습니다. 체감 속도와 품질은 직접 확인이 필요합니다.
4. 소넷 5.5가 맞지 않는 자리
Anthropic도 벤치마크는 능력의 한 단면이라고 선을 긋습니다. 판단을 오래 이어가야 하는 복잡하고 열린 문제는 오퍼스 5.5가 분명히 강하다는 게 공식 입장이죠.
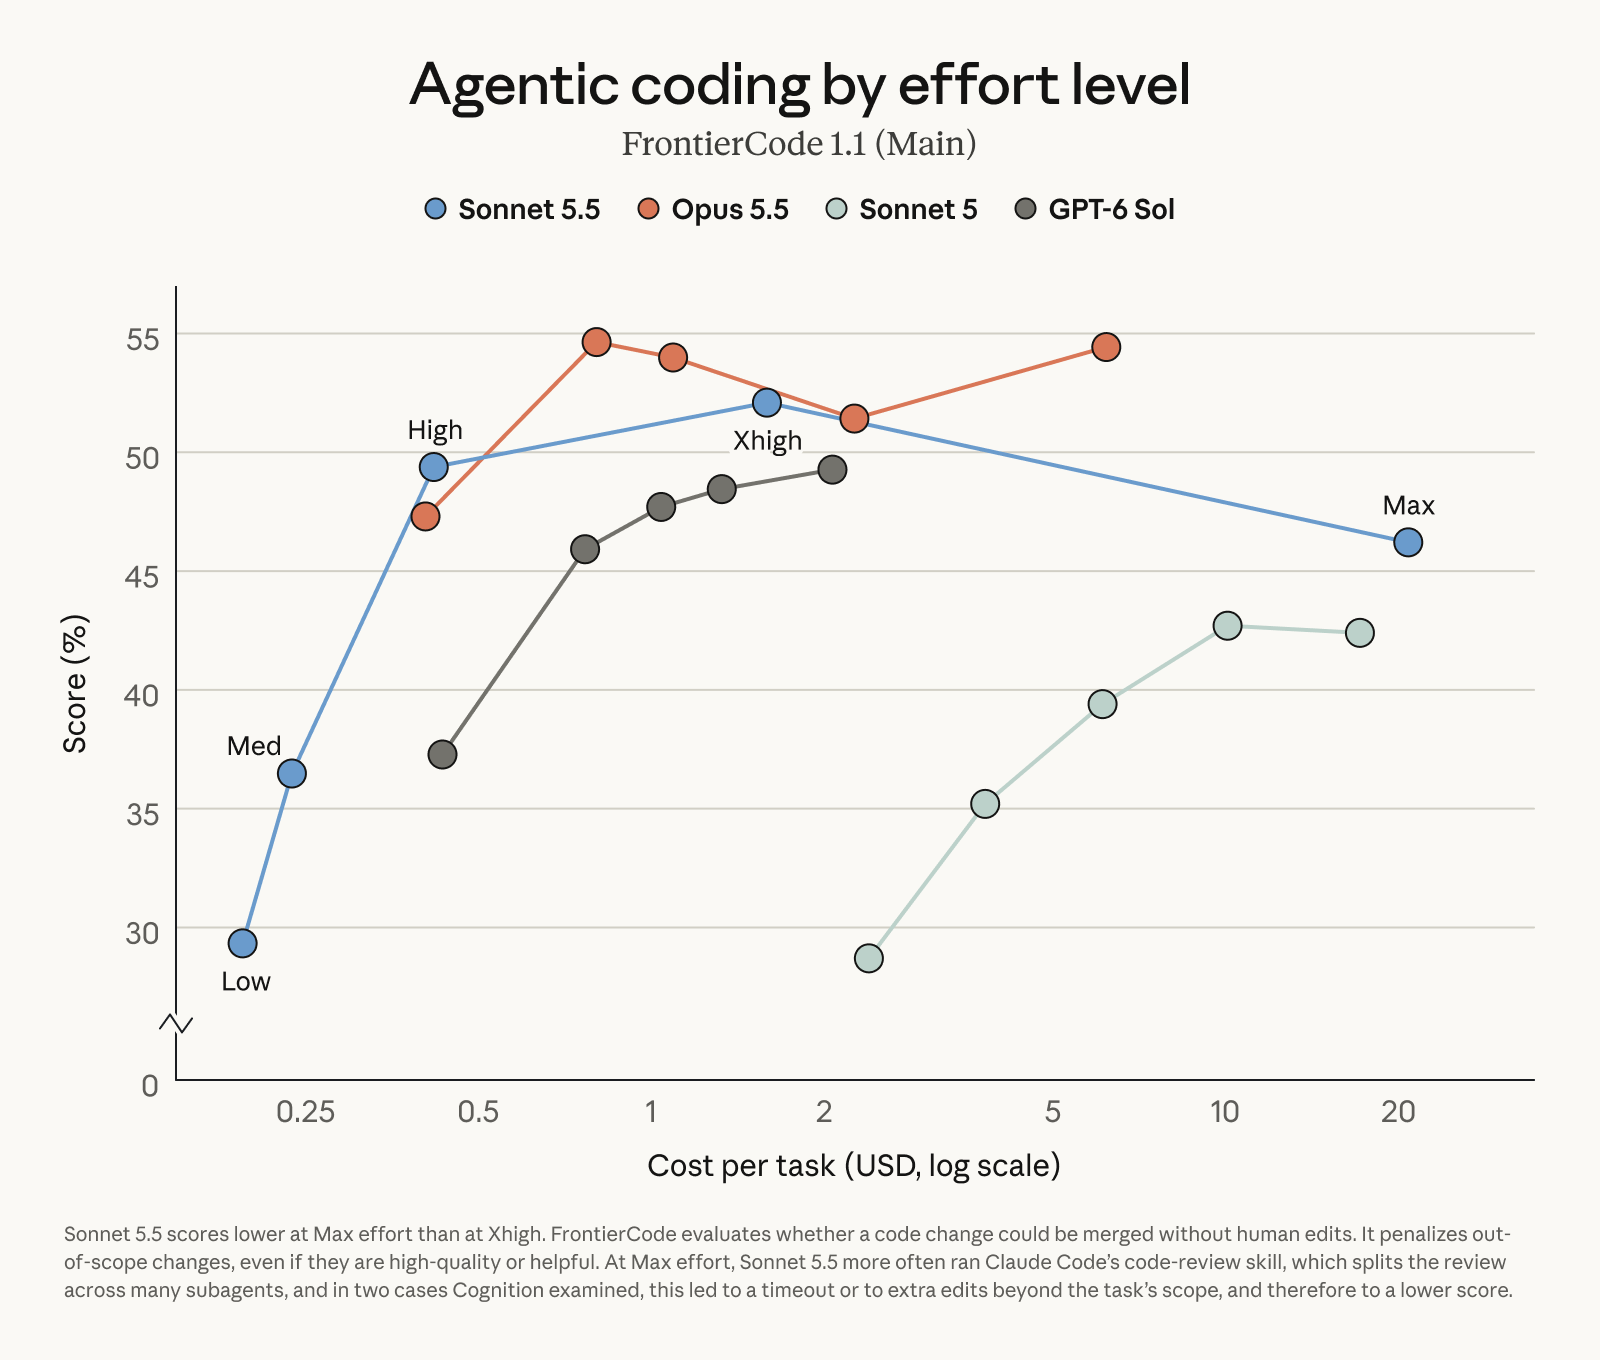
노력 수준을 무조건 올리는 것도 답이 아닙니다. 프런티어코드에서는 Max 설정이 Xhigh보다 점수가 낮았는데, 하위 에이전트 리뷰를 많이 돌리다 시간 초과나 범위 밖 수정이 생겼다고 합니다.
보안 쪽은 소넷 5.5가 사이버 안전장치를 단 첫 소넷이라 위험도가 높은 요청은 소넷 5로 넘어갑니다. 일반 개발·버그 수정은 영향이 없습니다.
문서와 슬라이드를 잘 만든다는 점도 반대로 봐야 합니다. 초안이 매끄러울수록 숫자와 근거를 사람이 다시 확인하는 단계가 빠지기 쉽죠. AI로 쓴 사업계획서를 발표 전에 점검하는 질문과 AI 논문 피드백의 한계에서 정리한 기준이 그대로 적용됩니다.
자주 묻는 질문 (FAQ)
Q. 소넷 5를 쓰던 사람은 바로 갈아타야 하나요?
A. 가격이 같고 속도와 점수가 올라 옮길 이유는 충분합니다. 다만 API 사용자는 표 2부터 확인하세요.
Q. 가격은 정확히 얼마인가요?
A. 100만 토큰당 입력 $2, 출력 $10, 캐시 읽기 $0.20입니다. 배치 API는 50% 할인이 적용됩니다.
Q. 오퍼스 5.5 대신 써도 될까요?
A. 범위가 분명한 코딩·문서 작업은 소넷 5.5로 충분할 수 있습니다. 판단이 길게 이어지는 일은 오퍼스 5.5가 낫다는 게 공식 설명입니다.
Q. 벤치마크 점수만 믿고 골라도 되나요?
A. 공식 발표도 벤치마크를 한 단면이라고 밝힙니다. 내 작업으로 Low·Medium·High를 돌려 비용과 품질을 비교하는 게 확실합니다.
정리하면
- 소넷 5.5는 가격은 그대로, 속도는 30% 이상 빨라진 소넷입니다.
- 30% 절감은 토큰을 덜 써서 생기는 작업당 최대치입니다.
- 일부 점수는 오퍼스 5.5에 근접하지만 복잡한 판단은 오퍼스가 앞섭니다.
- API는 thinking·도구 강제·컴퓨터 사용 설정부터 점검해야 합니다.
- 오늘은 내 작업 하나를 Medium으로 돌려 비용을 재 보세요. 관련 정리는 AI 활용 카테고리에 있습니다.
※ Anthropic 공식 발표문, 소넷 5.5 개발자 문서·마이그레이션 가이드, 공식 X(@claudeai) 게시물을 대조했고 벤치마크는 Anthropic 공개 수치만 다뤘습니다.
※ 2026년 9월 29일 기준이며, 가격·기본 설정·제공 범위는 공식 공지에 따라 바뀔 수 있습니다.
반응형
'AI 활용' 카테고리의 다른 글
| OpenAI o 에이전트 공개 D-1 — 확인된 것·유출·기능 팩트체크 (0) | 2026.09.29 |
|---|---|
| Opus 5.5로 모션 디자인 스튜디오 만드는 법 — 12단계 풀코스 번역(복붙 자료) (0) | 2026.09.29 |
| 메타 뮤즈 한국 사용법 — 아이폰 설치·리딤코드·활용법 (0) | 2026.09.27 |
| AI 논문 피드백의 한계와 활용법: 주장·방법·인용을 따로 점검하는 순서 (0) | 2026.09.20 |
| AI로 사업계획서 썼다면 발표 전에 이 질문부터 확인해야 한다 (0) | 2026.08.29 |


